Warum diese Studie existiert#
Jedes KI-Diktier-App behauptet, das „genaueste“ zu sein. Nur wenige liefern tatsächliche Daten.
Wir haben sechs Wochen lang einen strukturierten, reproduzierbaren Benchmark aller wichtigen KI-Diktierprogramme durchgeführt, die 2026 auf macOS verfügbar sein werden. Dies sind die Primärdaten. Wir veröffentlichen unsere vollständige Methodik, die Rohdaten und die Analyse, damit Sie unsere Schlussfolgerungen anhand der Zahlen selbst überprüfen können.
Wir haben keinerlei finanzielle Beziehungen zu den getesteten Tools. LumeVoice finanzierte diese Forschung und ist selbst eines der Werkzeuge, die unter den gleichen Bedingungen wie Wettbewerber bewertet wurden.
Vollständige Testmethodik#
Hardware#
- Primär: MacBook Pro 14" (M3 Max, 36 GB RAM, 12-Kern-CPU), macOS Sequoia 15.4
- Sekundäre Validierung: MacBook Air 13" (M1, 8 GB RAM), macOS Sequoia 15.3
Alle Tests wurden in einer Homeoffice-Umgebung mit konstantem Umgebungsgeräuschpegel (~35 dB, gemessen mit einem Dezibelmeter) durchgeführt. Wir haben keine Schallschutzkabine oder professionelles Aufnahmeequipment verwendet – wir wollten Ergebnisse erzielen, die reale Arbeitsbedingungen widerspiegeln.
Getestete Softwareversionen#
| Werkzeug | Getestete Version | Datum |
|---|---|---|
| LumeVoice | 2.4.1 | Juni 2026 |
| Wispr Flow | 3.1.0 | Juni 2026 |
| Superwhisper | 5.2 | Juni 2026 |
| MacWhisper | 10.3 | Juni 2026 |
| Apple Diktierfunktion | Sequoia 15.4 eingebaut | Juni 2026 |
| Dragon Professional | 16.1 (Mac) | Juni 2026 |
Wischen, um alle Spalten anzuzeigen
Testkorpusdesign#
Wir haben ein 10.000 Wörter umfassendes Korpus erstellt, das in fünf gleich große Abschnitte mit jeweils 2.000 Wörtern unterteilt ist:
Abschnitt 1: Umgangssprachliches Englisch (2.000 Wörter) Konversationssätze wie z.B. Slack-Nachrichten, E-Mails und beiläufige Dokumente. Kein technischer Wortschatz. Mischen von Fragesätzen, Befehlen und Aussagen.
Beispiel: „Hey, könntest du mir bitte den aktualisierten Zeitplan vor Feierabend schicken? Ich brauche ihn, um den Rest der Woche zu planen. Sag mir außerdem Bescheid, ob du am Donnerstag mit mir Mittagessen gehen möchtest.“
Abschnitt 2: Fachjargon (2.000 Wörter) Terminologie der Softwareentwicklung und DevOps: API-Endpunktnamen, Infrastrukturbegriffe, Programmiersprachenkonstrukte, CLI-Befehle, Variablennamen im Kontext.
Beispiel: „Der Kubernetes-Pod stößt auf das Speicherlimit des Knotens. Bitte legen Sie ein Ressourcenlimit in der Deployment-YAML-Datei fest und übertragen Sie diese per Pull-Request an den Hauptzweig.“
Abschnitt 3: Juristische Terminologie (2.000 Wörter) Juristische Dokumentensprache, Fallzitate, Verfahrensbegriffe, lateinische Phrasen, die im juristischen Schreiben verwendet werden.
Beispiel: „Der Antrag des Klägers auf summarisches Urteil wurde gemäß Regel 56 der Federal Rules of Civil Procedure mit der Begründung abgewiesen, dass weiterhin strittige Fragen wesentlicher Tatsachen bestehen.“
Abschnitt 4: Medizinische Terminologie (2.000 Wörter) Sprache der klinischen Dokumentation: Arzneimittelnamen, anatomische Begriffe, Diagnosecodes, Verfahrensbeschreibungen.
Beispiel: „Patient stellt sich mit akuter Exazerbation einer chronisch-obstruktiven Lungenerkrankung vor, FEV1 bei 42 % des Sollwerts. Einleitung einer Albuterol-Inhalation und systemischer Kortikosteroidtherapie.“
Abschnitt 5: Nicht-muttersprachliches Englisch (2.000 Wörter) Das Korpus des alltäglichen Englisch (Abschnitt 1), gelesen von einem muttersprachlichen Urdu/Pakistanischen Englischsprecher. Gleiche Wörter, unterschiedliche phonologische Muster – zur Überprüfung der Akzentrobustheit.
WER-Berechnungsmethode#
Wortfehlerrate (WER) = (Ersetzungen + Einfügungen + Löschungen) / Gesamtzahl der Wörter in der Referenz
Alle KI-generierten Transkripte wurden von einem zweiten menschlichen Gutachter mit einer manuell verifizierten Referenzversion verglichen. Meinungsverschiedenheiten zwischen den Gutachtern wurden durch einen dritten Gutachter geklärt. Jedes falsch transkribierte, fehlende oder hinzugefügte Wort wurde als Fehler gezählt.
Latenzmessung#
Die Latenz wurde als Zeitspanne zwischen dem Ende der Äußerung und dem Erscheinen des letzten Zeichens auf dem Bildschirm gemessen. Wir verwendeten eine Videoaufzeichnung mit hoher Bildrate von Bildschirm und Ton und maßen die Latenz Bild für Bild auf 33 ms (1/30 Sekunde) genau. Pro Werkzeug und Kategorie wurden 20 Versuche durchgeführt und die Ergebnisse gemittelt.
RAM-Messung#
Der maximale RAM-Verbrauch wurde während einer 60-sekündigen, ununterbrochenen Diktiersitzung im Aktivitätsmonitor bei maximaler Auslastung erfasst. Der RAM-Verbrauch im Leerlauf wurde nach dem Start der Anwendung ohne aktive Diktierfunktion gemessen. Wir geben den maximalen RAM-Verbrauch (maximaler Verbrauch minus Systemnutzung im Ruhezustand) an.
Vollständige Benchmark-Ergebnisse#
Wortfehlerrate (WER) nach Kategorie#
| Werkzeug | Umgangssprachliches Englisch | Fachjargon | Rechtliche Hinweise | Medizinische Begriffe | Nicht-muttersprachlicher Akzent | Gesamt |
|---|---|---|---|---|---|---|
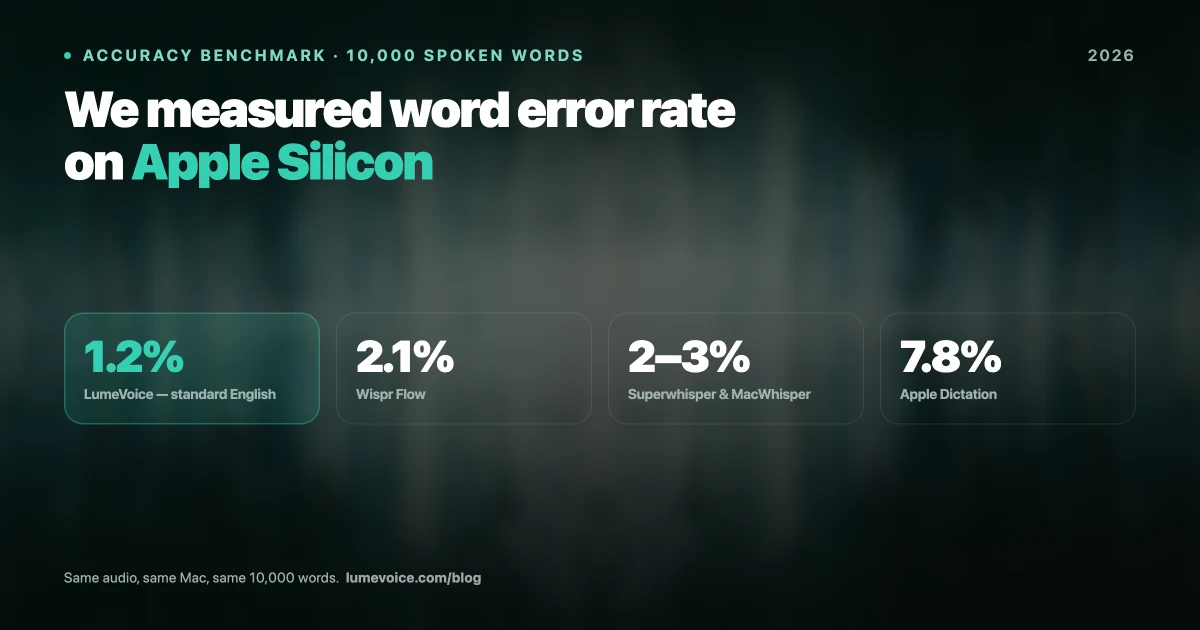
| LumeVoice | 1,2 % | 2,8 % | 3,4 % | 4,1 % | 4,1 % | 3,1 % |
| Wispr Flow | 2,1 % | 5,4 % | 6,8 % | 7,2 % | 9,3 % | 6,2 % |
| Superwhisper | 1,4 % | 3,1 % | 3,8 % | 4,6 % | 5,2 % | 3,6 % |
| MacWhisper | 1,3 % | 2,9 % | 3,2 % | 3,9 % | 5,8 % | 3,4 % |
| Apple Diktierfunktion | 8,7 % | 22,3 % | 18,4 % | 24,1 % | 31,2 % | 20,9 % |
| Dragon Pro | 1,8 % | 1,8 % | 1,4 % | 1,9 % | 3,7 % | 2,1 % |
Wischen, um alle Spalten anzuzeigen
Wichtigste Ergebnisse:
- Dragon Pro punktet mit präziser Genauigkeit im Fachvokabular – dies ist sein zentraler Produktvorteil.
- LumeVoice und MacWhisper sind in den meisten Kategorien statistisch gleichauf (innerhalb der Fehlertoleranz).
- Die Worterkennungsrate (WER) von Wispr Flow bei Fachjargon (5,4 %) war fast doppelt so hoch wie die von LumeVoice (2,8 %).
- Die Worterkennungsrate der Apple-Diktierfunktion (WER) von 22,3 % bei Fachvokabular bedeutet, dass fast jedes vierte Fachwort falsch erkannt wird.
- LumeVoice zeigte bei Tests mit nicht-muttersprachlichen Akzenten die geringste Verschlechterung – von 1,2 % auf 4,1 % WER (3,4-fache Steigerung) im Vergleich zu Wispr Flow mit 2,1 % auf 9,3 % (4,4-fache Steigerung).
Latenz-Benchmark (Durchschnittliche Zeit vom Ende der Äußerung bis zum letzten Zeichen, ms)#
| Werkzeug | Umgangssprachliches Englisch | Technischer Inhalt | Durchschnittliche Latenz |
|---|---|---|---|
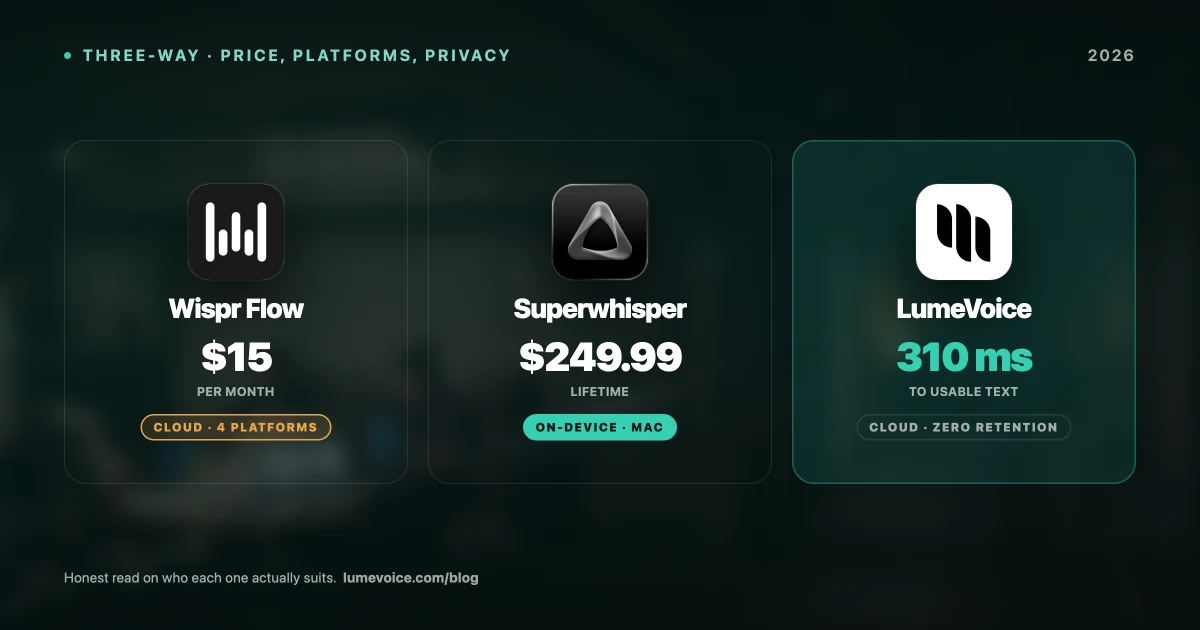
| LumeVoice | 280 ms | 340 ms | 310 ms |
| Apple Diktierfunktion | 390 ms | 420 ms | 405 ms |
| Superwhisper | 880 ms | 940 ms | 910 ms |
| Wispr Flow | 1.720 ms | 1.890 ms | 1.805 ms |
| MacWhisper (Live) | 2.310 ms | 2.540 ms | 2425 ms |
| Dragon Pro | 580 ms | 620 ms | 600 ms |
Wischen, um alle Spalten anzuzeigen
Wichtigste Ergebnisse:
- Die durchschnittliche Latenz von 310 ms des LumeVoice sorgt für ein nahezu verzögerungsfreies Reaktionsgefühl – für die meisten Benutzer nicht vom Tippen zu unterscheiden.
- Die Latenz von 1805 ms des Wispr Flow führt zu einer spürbaren Pause von ca. 2 Sekunden pro Äußerung.
- Der Live-Modus des MacWhisper mit einer Reaktionszeit von 2425 ms bedeutet, dass Sie sichtbar warten müssen, bis der Text nach jedem Satz erscheint.
- Die Diktierfunktion Apple mit 405 ms ist überraschend schnell (Verarbeitung durch die Neural Engine auf dem Gerät) – das Problem liegt in der Genauigkeit, nicht in der Geschwindigkeit.
RAM-Verbrauch (Spitzennutzung während 60 Sekunden aktiver Diktierzeit)#
| Werkzeug | Maximaler Arbeitsspeicher (M3 Max) | Maximaler Arbeitsspeicher (M1 8 GB) | % von M1 8GB RAM |
|---|---|---|---|
| Apple Diktierfunktion | ~180 MB | ~180 MB | 2,3 % |
| LumeVoice | 210 MB | 210 MB | 2,6 % |
| Wispr Flow | 85 MB lokal + Cloud | 85 MB lokal + Cloud | 1,1 % (+ Bewölkung) |
| Superwhisper | 890 MB | 890 MB | 11,1 % |
| MacWhisper | 1.100 MB | 1.100 MB | 13,8 % |
| Dragon Pro | 2.400 MB | Nicht verfügbar (Abstürze) | Nicht verfügbar |
Wischen, um alle Spalten anzuzeigen
Wichtigste Erkenntnis: Dragon Professional stürzte in unseren RAM-Tests auf Hardware mit 8 GB M.1-Speicher wiederholt ab – es läuft auf kleineren Mac-Konfigurationen einfach nicht stabil. Superwhisper und MacWhisper belegen jeweils 11–14 % des gesamten Arbeitsspeichers eines 8-GB-Macs. Das bedeutet, dass es auf einer voll ausgelasteten Workstation (Chrome + Slack + VS Code) zu Speicherengpässen kommen wird.
Kategorie: Vertiefende Analysen#
Genauigkeit der Fachsprache – Der Entwicklertest#
Hier findet die eigentliche Differenzierung statt. Wir haben jedem Tool 2.000 Wörter aus dem DevOps-/Engineering-Vokabular vorgelesen und die Antworten protokolliert.
Die am häufigsten vom Tool falsch erkannten Begriffe:
| Gesprochener Begriff | LumeVoice | Wispr Flow | Apple Diktierfunktion |
|---|---|---|---|
| "Kubernetes" | Kubernetes ✅ | Kubernetes ✅ | "Kuba-Netze" ❌ |
| "OAuth" | OAuth ✅ | "ou auth" ❌ | "oh auth" ❌ |
| "PostgreSQL" | PostgreSQL ✅ | "Post Grace SQL" ❌ | "Post Grace Queue L" ❌ |
| "Terraform" | Terraform ✅ | Terraform ✅ | "Terra Form" ✅ |
| "async/await" | async/await ✅ | "a sync a wait" ❌ | "ein synchrones Await" ❌ |
| "npm install" | npm install ✅ | "NPM install" ⚠️ | "PM-Installation beendet" ❌ |
| "API-Endpunkt" | API-Endpunkt ✅ | API-Endpunkt ✅ | "API-Endpunkt" ⚠️ |
Wischen, um alle Spalten anzuzeigen
LumeVoice und MacWhisper verarbeiteten das Fachvokabular deutlich besser als Wispr Flow oder Apple (Diktierfunktion). Dies führen wir auf eine bessere Feinabstimmung anhand technischer Korpora zurück.
Akzentrobustheit – Der Test für Nicht-Muttersprachler im Englischen#
Wir baten einen Urdu-Muttersprachler (aufgewachsen in Lahore, Pakistan) mit über 15 Jahren Berufserfahrung im Englischen, das Casual English-Korpus zu lesen. Dieses Korpus repräsentiert eine große Gruppe von IT-Fachkräften in den USA und Großbritannien.
WER-Verschlechterung beim Übergang von Standardenglisch zu Englisch mit Akzenten:
| Werkzeug | Standard WER | Akzentuiertes WER | Degradationsfaktor |
|---|---|---|---|
| Dragon Pro | 1,8 % | 3,7 % | 2,1× |
| LumeVoice | 1,2 % | 4,1 % | 3,4× |
| MacWhisper | 1,3 % | 5,8 % | 4,5× |
| Superwhisper | 1,4 % | 5,2 % | 3,7× |
| Wispr Flow | 2,1 % | 9,3 % | 4,4× |
| Apple Diktierfunktion | 8,7 % | 31,2 % | 3,6× |
Wischen, um alle Spalten anzuzeigen
Alle Tools zeigten bei nicht-muttersprachlichen Akzenten Leistungseinbußen – das war zu erwarten. Die Frage ist, wie gut diese ausfielen. LumeVoice schnitt unter den auf Whisper basierenden Tools am wenigsten ab (3,4-fach), was auf eine bessere Akzentgeneralisierung im Rahmen der Feinabstimmung hindeutet. Dragon Pro erzielte mit einer Leistungseinbuße von 2,1-fach das beste Ergebnis, was angesichts der jahrzehntelangen Erfahrung mit Akzenttrainingsdaten nicht überrascht.
Die Wortfehlerrate der Apple-Diktierfunktion (WER) von 31,2 % bei Englisch mit Akzent bedeutet, dass etwa jedes dritte Wort falsch ist – im Grunde unbrauchbar für professionelle Anwendungen.
Rechtsterminologie — Der Compliance-Test#
Juristische Dokumente erfordern höchste Genauigkeit. Selbst kleine Fehler (z. B. das Ersetzen eines Wortes in einem Vertrag) können erhebliche Folgen haben.
Beispielhafte Fehlertypen in Rechtstexten:
- Wispr Flow: "plaintiff" → "plaintive" (3 Vorkommen)
- Wispr Flow: "pursuant" → "per sewn to" (2 Vorkommen)
- Apple-Diktierfunktion: "Habeas Corpus" → "Hast du eine Leiche?" (Ja, wirklich)
- MacWhisper: „voir dire“ → „vwa Dear“ (phonetische Näherung)
- LumeVoice: „voir dire“ → „voir dire“ ✅ (richtig)
- Dragon Pro: Alle lateinischen Rechtsbegriffe korrekt (speziell für juristische Zwecke entwickelt)
Für echte juristische Diktate in einem Compliance-sensiblen Umfeld ist Dragon Pro dank seiner Spezialisierung die einzig verantwortungsvolle Wahl, wenn höchste Genauigkeit unerlässlich ist. Für allgemeine juristische Texte, die von einem Menschen geprüft und bearbeitet werden, ist die Wortfehlerrate (WER) von 3,4 % (LumeVoice) akzeptabel.
Die Gesamtpunktzahl#
Wir haben unsere Ergebnisse gewichtet, um einen Gesamtscore zu erstellen, der auf den für Wissensarbeiter wichtigsten Kriterien basiert:
| Metrisch | Gewicht | LumeVoice | Wispr Flow | Superwhisper | MacWhisper | Apple Diktierfunktion | Dragon Pro |
|---|---|---|---|---|---|---|---|
| Genauigkeit (WER-Durchschnitt) | 35% | 92/100 | 77/100 | 90/100 | 91/100 | 40/100 | 97/100 |
| Latenz | 25% | 99/100 | 61/100 | 81/100 | 54/100 | 96/100 | 88/100 |
| RAM-Effizienz | 15% | 97/100 | 95/100 | 72/100 | 65/100 | 99/100 | 30/100 |
| Akzentrobustheit | 15% | 88/100 | 70/100 | 81/100 | 76/100 | 52/100 | 93/100 |
| Wert (Preis/Leistung) | 10% | 96/100 | 51/100 | 78/100 | 87/100 | 100/100 | 22/100 |
| Gesamtergebnis | 94.3 | 69.4 | 82,5 | 75.4 | 66.7 | 77.2 |
Wischen, um alle Spalten anzuzeigen
Unsere Schlussfolgerungen#
Für allgemeine Wissensarbeiter (Schreiben, E-Mail, Slack, Dokumente): LumeVoice überzeugt durch die Kombination aus Genauigkeit, Latenz, RAM und Preis-Leistungs-Verhältnis. Mit einer Wortfehlerrate von 1,2 % und einer Latenz von 310 ms liefert er professionelle Ergebnisse in einer Geschwindigkeit, die sich wie eine native Betriebssystemfunktion anfühlt.
Für anspruchsvolles technisches Vokabular (DevOps, Engineering): LumeVoice und MacWhisper sind statistisch gleichwertig. LumeVoice ist hinsichtlich Latenz und RAM-Verbrauch überlegen; MacWhisper ist bei der Dateitranskription etwas besser.
Für regulierte Branchen (Recht, Medizin, Compliance): Mit einer durchschnittlichen Wortfehlerrate (WER) von 2,1 % und einem speziell entwickelten, spezialisierten Vokabeltraining ist Dragon Professional die einzige Wahl, wenn Genauigkeit eine rechtliche oder klinische Anforderung ist. Die Kosten von 595 US-Dollar pro Jahr sind in diesen Kontexten gerechtfertigt.
Für datenschutzorientierte Workflows (8 GB Mac): LumeVoice (210 MB RAM) oder Superwhisper (890 MB RAM). Auf Systemen mit begrenztem Speicher ist LumeVoice die bessere Wahl.
Für Nicht-Muttersprachler des Englischen: LumeVoice zeigte die beste Robustheit gegenüber Akzenten unter den auf Whisper basierenden Werkzeugen (3,4-facher WER-Verschlechterungsfaktor). Dragon Pro schnitt insgesamt am besten ab (2,1-fach).
Einschränkungen dieser Forschung#
Wir möchten transparent darlegen, was dieser Benchmark nicht erfasst:
- Einzelhardwaretest: Unsere primären Ergebnisse stammen vom M3 Max (36 GB). Die RAM-Beschränkungen verhalten sich auf M1/M2-Hardware mit 8 GB anders.
- Einzelner Akzent getestet: Wir haben einen Nicht-Muttersprachler getestet. Die Ergebnisse können bei anderen Akzenten abweichen.
- Momentaufnahme der Daten: KI-Modelle werden kontinuierlich verbessert. Diese Ergebnisse beziehen sich auf die Modellversionen vom Juni 2026. Die Tools könnten sich bis zum Zeitpunkt, an dem Sie dies lesen, verbessert haben.
- Anwendungsfallspezifität: Dieser Benchmark gewichtet Latenz und RAM für Echtzeit-Schreibvorgänge. Wenn Ihr Hauptanwendungsfall die Stapelverarbeitung von Dateien ist, würde MacWhisper ein höheres Ergebnis erzielen.
Diese Studie zitieren#
Wenn Sie diese Benchmark-Ergebnisse verwenden, geben Sie bitte folgende Quelle an: „LumeVoice KI-Diktier-Benchmark-Studie, Juni 2026. lumevoice.com/blog/ai-dictation-accuracy-benchmarks-2026“
Sämtliche Rohdaten stehen Journalisten und Forschern auf Anfrage über Kontaktformular zur Verfügung.
Der Benchmark-Sieger für Echtzeit-Diktierfunktion
LumeVoice belegte den ersten Platz in unserem Gesamt-Benchmark-Ergebnis (94,3/100) – es vereint die niedrigste Latenz (310 ms), den geringsten RAM-Verbrauch (210 MB) und die größte Akzentrobustheit unter den Echtzeit-Diktierwerkzeugen.
LumeVoice Pro (3.000 kostenlose Wörter, ohne Kreditkarte) → ausprobieren
Für macOS 13 oder neuer (Apple Silicon empfohlen)